

Tópicos desta notícia (8)
O que aconteceu
Desde 15 de setembro de 2026, bloquear crawler de IA deixou de ser um interruptor único. A Cloudflare — que responde por mais de 20% dos domínios do mundo — aposentou a opção “Block AI Bots” e passou a separar o tráfego automatizado em três controles independentes: busca, agente e treinamento (anúncio oficial da Cloudflare). Junto veio o “Disallow AI Training”, que recusa treinamento sem tirar o site da busca, e a mudança de significado do bloqueio total: a opção agora alcança também os crawlers de uso misto — Googlebot, Bingbot e Applebot — e derruba a busca tradicional junto (release da Cloudflare).
Para domínio novo que exibe anúncio, a configuração recomendada passou a ser busca liberada, treinamento recusado e agentes bloqueados nas páginas com anúncio; site sem anúncio começa com os três liberados. A escolha, agora, precisa ser explícita — e errar de botão tem efeito colateral na busca.
Do outro lado da pilha, o Google liberou em 31 de agosto de 2026 o controle de IA generativa do Search Console, que permite sair dos recursos de IA da busca sem perder posição na busca tradicional (Google).
Por que isso está acontecendo
O volume explica. Em 2025, 53% de todo o tráfego da web já era automatizado, contra 47% humano, e os ataques com bots turbinados por IA cresceram 12,5 vezes em um ano (2026 Thales Bad Bot Report). Na Cloudflare, as requisições diárias de agentes de IA cresceram mais de 1.700% em doze meses (Cloudflare).
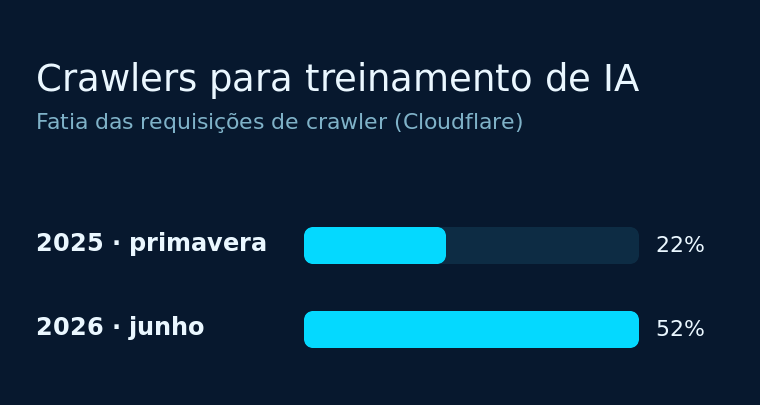
O que virou a chave foi a proporção de uso: na primavera de 2025, 22% das requisições de crawler declaradas eram para treinamento; em junho de 2026, 52% (Cloudflare). Crawlers de uso misto — o mesmo robô servindo busca e treinamento — já são 36,6% do tráfego verificado de crawlers, a maior categoria isolada, e menos de 1% dos sites bloqueia crawler de busca, enquanto 17% restringem treinamento (release da Cloudflare).
Traduzindo: o dono de site nunca quis desaparecer da busca, quis parar de alimentar de graça o modelo de outra empresa. Até setembro, as duas coisas vinham no mesmo pacote.
O que isso muda para uma PME brasileira
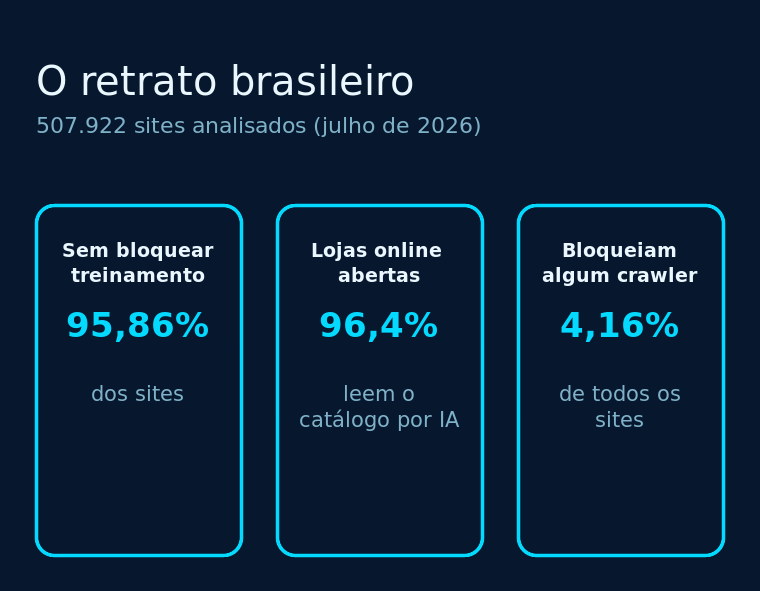
O Brasil está no lado aberto da balança. Um levantamento com 507.922 sites brasileiros mostrou que 4,16% bloqueiam algum crawler de IA e 95,86% não bloqueiam nenhum bot de treinamento; 88,83% não tomaram decisão alguma — nem bloquearam, nem declararam política (Piperic, AI Access Report Brasil). Entre as lojas online, 96,4% (73.904 de 76.640) estão abertas a crawlers de IA, que já leem, comparam e recomendam o catálogo (Piperic).
Isso importa porque a decisão de compra do brasileiro ganhou um intermediário. Na pesquisa Black Friday Talks, da Stefanini Marketing, 86% dos consumidores vão usar IA nas compras de novembro — para comparar preços (49%), checar se a promoção é real (47%) e avaliar a confiabilidade da loja (42%) —, e cerca de metade das fontes que a IA usa nessas respostas é editorial (UOL Economia).
O detalhe brasileiro está no paradoxo: 19.457 sites bloqueiam o GPTBot para manter o conteúdo fora do treinamento, mas 1.033 deles (5,3%) bloqueiam junto o OAI-SearchBot, o robô que decide se o site aparece nas respostas do ChatGPT (Piperic). Protegeram o conteúdo e sumiram do canal, provavelmente sem saber, porque os dois tokens são independentes no robots.txt.
Onde faz sentido usar
- Loja com anúncio no site: revisar o que o CDN já bloqueia por padrão. Desde 15/09, recusar treinamento em página com anúncio é o caminho recomendado, mas não pode levar o crawler de busca junto.
- Site institucional que quer ser citado: liberar busca e agente. A resposta do assistente virou canal de descoberta, e quem não é lido não é citado — é o que a auditoria de SEO da Canis verifica primeiro.
- Blog ou conteúdo editorial que serve de fonte: permitir busca e citação e decidir treinamento caso a caso. Metade das fontes usadas pela IA em resposta de compra é editorial.
- Catálogo ou base de preços que é ativo do negócio: aqui bloqueio e cobrança por acesso passam a fazer sentido; é o caso em que sumir da resposta pode valer mais do que aparecer.
Nos quatro casos, o trabalho começa por uma auditoria de indexação.
Riscos e limites
Nada disso é controle de segurança. robots.txt é pedido, não imposição: crawler que ignora o arquivo só para com firewall ou limite de requisições. E a lista tem furos: a Microsoft deve passar a respeitar a preferência de “sem treinamento” via robots.txt apenas no início de 2027; até lá, quem quer bloquear treinamento no Bing precisa usar a meta tag NOARCHIVE (Cloudflare).
Bloquear demais também é irreversível na prática. Conteúdo já absorvido por um modelo não sai do modelo, e o Googlebot é crawler de uso misto: escolher o bloqueio total em treinamento derruba a busca junto. Não existe botão de desfazer.
O que avaliar antes de implementar
Quatro verificações, nesta ordem:
- O que o seu CDN ou host já bloqueia por padrão. Configuração antiga ligada sem o dono saber é a causa mais comum de site invisível para IA.
- Separe por função, não por nome de robô. Busca (aparecer), agente (atender quem pediu) e treinamento (alimentar modelo) são decisões diferentes; tratar as três como uma só produz o paradoxo brasileiro.
- Teste em modo de registro antes de bloquear. Regra promovida direto para bloqueio derruba tráfego legítimo, inclusive o que se quer manter.
- Meça o efeito. O Search Console mostra impressões em recursos de IA generativa e permite sair deles sem perder posição na busca tradicional — é o medidor mais próximo do que existe hoje (Google).
Fontes
- Cloudflare — Have it both ways: stay discoverable in search while disallowing AI training (15/09/2026) — fonte primária, acesso em 07/10/2026
- Cloudflare — Press release: Cloudflare Helps End the Search-or-AI-Training Tradeoff (15/09/2026)
- Cloudflare — The Internet has a second audience
- Thales/Imperva — 2026 Bad Bot Report (29/04/2026)
- Google Search Console — Search generative AI control (global desde 31/08/2026)
- Piperic — AI Access Report: Brazil (13/07/2026)
- UOL Economia — Black Friday: IA vira “auditora” de preços e promoções (11/09/2026)
A informação foi verificada em pelo menos duas fontes independentes. Trechos citados estão entre aspas e atribuídos à fonte original.
Conclusão
A pergunta deixou de ser “bloquear ou não bots de IA” e passou a ser “bloquear o quê, em qual página e por quê”. Com o padrão novo, o silêncio não é neutro: quem não configura fica com o padrão de outra pessoa, e o padrão brasileiro, hoje, é deixar tudo aberto por não ter decidido nada. Antes da Black Friday, vale conferir o que o seu site responde a um robô de IA.
Sua loja aparece quando alguém pergunta à IA? A Canis audita indexação, robots.txt e sinais de IA para responder isso com dado, não com achismo. Falar com a Canis →


