

Tópicos desta notícia (8)
- 01O que a Brave vende para empresas de IA
- 02Seu site provavelmente está nesse índice — como conferir
- 03Por que não dá para bloquear o crawler da Brave sem bloquear o Google
- 04O que a ação do New York Times alega (e o que ainda é alegação)
- 05O que isso muda para uma PME brasileira
- 06Riscos e limites
- 07Fontes
- 08Fechamento
O New York Times processou a Brave Software em 2 de novembro, no tribunal federal de Manhattan, acusando a empresa do navegador e do buscador Brave de copiar mais de 30 bilhões de páginas para o índice que vende a empresas de inteligência artificial. A petição afirma que o rastreador da Brave nunca se identificou e que os donos de sites não têm como bloquear só ele. A empresa não havia respondido publicamente até a tarde de 6 de novembro.
O que a Brave vende para empresas de IA
A Brave Search não é uma cópia do Google nem do Bing. A empresa mantém um índice próprio, que a página oficial do Brave AI descreve como um acervo de mais de 30 bilhões de páginas, com milhões de novas indexadas por dia. É esse acervo que a Brave Search API comercializa como acesso em tempo real ao conteúdo da web para quem constrói modelos e agentes de IA.
A página institucional da Brave cita Cohere, Mistral, Perplexity e You.com entre os clientes da API. A petição do Times acrescenta Anthropic e xAI à lista de empresas que, segundo os autores, pagam para usar o índice. Nenhuma dessas cinco empresas é ré no processo. O texto também mira dois produtos específicos: o Ask Brave, que usa trechos do índice para gerar respostas, e o endpoint LLM Context, que entrega trechos de páginas e metadados prontos para um modelo de linguagem.
A ação pede indenização, devolução de lucros e uma liminar permanente. No mesmo dia, Daily News, Chicago Tribune e Orlando Sentinel entraram com um processo semelhante. A Brave ainda não apresentou defesa.
Seu site provavelmente está nesse índice — como conferir
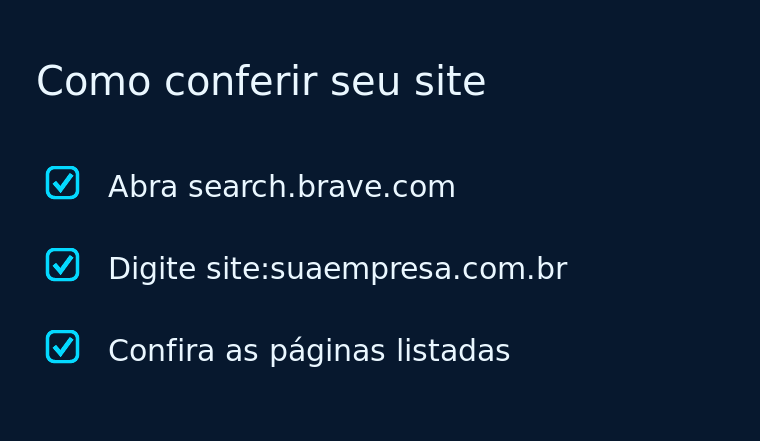
O teste leva menos de um minuto. Abra search.brave.com e digite site: seguido do seu domínio, sem espaço: site:suaempresa.com.br. Os resultados que aparecerem são páginas suas que a Brave mantém no índice — o mesmo acervo que a API vende. Se aparecerem páginas que você não lembrava que existiam, elas também estão lá.
Não confunda o teste com uma leitura ao vivo do site. A própria página de ajuda da Brave explica que precisa rastrear a página de novo para aplicar uma mudança de noindex. Isso significa que o resultado pode vir de uma cópia armazenada, com título ou descrição antigos.
A pergunta que importa é o que desse conteúdo você não gostaria de ver virando insumo de resposta de IA.
Por que não dá para bloquear o crawler da Brave sem bloquear o Google
A mesma página de ajuda é explícita: o crawler da busca não anuncia um user-agent diferenciado porque, segundo a Brave, precisa evitar discriminação de sites que só permitem o Google. E acrescenta que, se um domínio ou página não pode ser rastreado pelo Googlebot, o robô da Brave também não rastreia.
O resultado prático é que não existe uma linha de robots.txt capaz de dizer Brave. Bloquear o Google também bloqueia a Brave; liberar o Google também libera a Brave. O mesmo vale para regras por user-agent no servidor: sem um identificador próprio, não há como separar um do outro.
A saída que a Brave indica é outra: usar a diretiva noindex e pedir o recrawl pela ferramenta de Submit URL. O efeito, porém, é o mesmo de sair do Google — a página some dos dois buscadores. Na documentação pública, não há um caminho para permanecer na busca e sair apenas do índice vendido para IA.
O que a ação do New York Times alega (e o que ainda é alegação)
A petição tem 72 páginas e cinco acusações: violação direta, contributiva e indireta de direitos autorais, violação da DMCA e enriquecimento ilícito. O texto descreve a Brave como fornecedora, revendedora e distribuidora de conteúdo protegido e afirma que o índice foi montado sem que a empresa se identificasse ou oferecesse aos donos de sites um mecanismo para bloquear o crawler.
Também entram na ação o Paywall blocker do navegador e a troca de anúncios: a Brave bloqueia a publicidade dos sites e mostra a própria. A empresa não é acusada de treinar um modelo próprio; é acusada de copiar, distribuir e vender o conteúdo que outros produziram — inclusive para treino por terceiros.
Nada disso é decisão judicial. A Brave ainda não apresentou defesa, e processos desse tipo costumam levar anos. Para o dono de site, o valor da petição é documental: ela reúne, com links, o que a própria Brave publica sobre o índice, o crawler e a API.
O que isso muda para uma PME brasileira
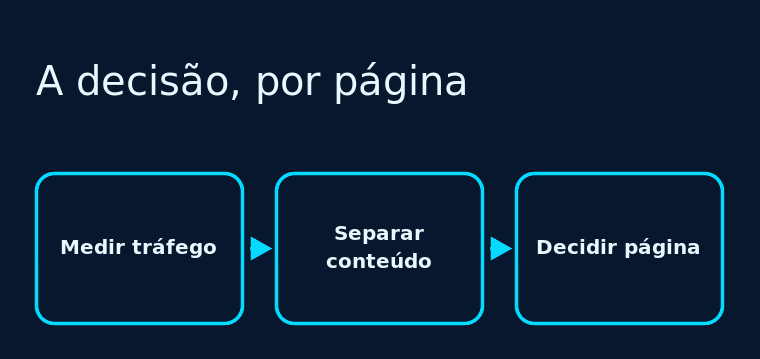
Para uma pequena empresa, o primeiro passo é medir. No GA4 ou no analytics do site, vale isolar a origem brave.com e comparar com o total. Se a Brave não aparece entre os canais relevantes, o risco não é de audiência: é de ter conteúdo original servindo de matéria-prima para respostas de IA sem retorno de visita.
A decisão é por página, não por site inteiro. Um catálogo de produtos pode se beneficiar de aparecer em mais um buscador. Já um conteúdo editorial que custou semanas de trabalho e diferencia a empresa tem outro peso na conta. Bloquear tudo para proteger uma parte costuma ser a pior combinação.
No começo de novembro, a Justiça de São Paulo proibiu a Meta de usar material jornalístico sem autorização, em ação de ANJ, Abert e Aner, com multa diária de R$ 1 milhão limitada a R$ 100 milhões, segundo o Globo. No Congresso, o PL 2338/2023, que trata do uso de conteúdo protegido por IA, segue na Câmara. Nenhuma das duas coisas resolve o caso da Brave, mas as duas mostram que a pergunta sobre quem paga pelo conteúdo usado em IA deixou de ser só americana.
Riscos e limites
O primeiro limite é que noindex não é bloqueio seletivo: a página sai do Google também. Para quem vive de busca orgânica, isso pode ser pior do que aparecer no índice da Brave.
O segundo é o bloqueio por IP ou user-agent. Como o crawler da Brave não se identifica, uma regra agressiva no servidor pode atingir o Googlebot e derrubar o site no Google — o oposto do que se queria.
O terceiro é o tempo. A ação foi proposta em 2 de novembro e não há decisão; a política da Brave pode não mudar. Mesmo que uma página seja removida do índice, não se sabe por quanto tempo cópias já entregues a clientes da API continuam em uso.
Por último, a medição tem limite: o volume de cliques atribuído a brave.com pode aparecer diluído no analytics.
Fontes
- Petição do New York Times contra a Brave (1:26-cv-09549) — 2/11/2026; acesso em 6/11/2026.
- Brave Search Crawler — página de ajuda — acesso em 6/11/2026.
- Brave — About — acesso em 6/11/2026.
- Brave AI — índice e Search API — acesso em 6/11/2026.
- Reuters — NYT processa fabricante do navegador Brave — 2/11/2026.
- TechCrunch — NYT e outros veículos processam a Brave — 2/11/2026.
- O Globo — decisão contra a Meta — 5/11/2026.
Fechamento
Para o dono de site, a decisão desta semana é medir antes de bloquear: conferir o que está no índice, separar o conteúdo que não deveria alimentar respostas de IA e só então escolher entre conviver com o risco ou aplicar noindex nas páginas certas — sabendo que a saída também vale para o Google. A ação do New York Times pode mudar as regras do jogo, mas não muda o que dá para fazer hoje.
Quer saber o que proteger no seu site? A Canis faz auditoria de SEO e ajuda a decidir quais páginas valem exposição em buscadores e IA. Falar com a Canis →


