
Tópicos desta notícia (8)
Em 28 de outubro de 2026, o Google anunciou o Gemini 4 Carbon, seu novo modelo de fronteira, com foco em cibersegurança e em tarefas de engenharia que duram horas ou dias. O anúncio coloca o modelo no topo do Artificial Analysis Intelligence Index v5, com nota 59, e promete o melhor desempenho já registrado em localizar, validar e corrigir vulnerabilidades. A ressalva está na segunda metade da notícia: quase ninguém pode usar o modelo ainda.
O que o Google anunciou em 28 de outubro
O Carbon é apresentado como o modelo mais forte do Google até aqui, construído sobre o Gemini 4 Argon, lançado duas semanas antes. A ênfase não é conversa geral, e sim trabalho longo: segundo o anúncio oficial, equipes internas viram o modelo rodar por dias para achar a causa raiz de bugs em bases de código grandes.
Os números que o Google destaca são de cibersegurança. O Carbon marca 88,2% no SEC-bench Pro, que mede a descoberta de vulnerabilidades reais; 54,8% no ExploitGym, que testa se a falha encontrada é explorável; e 71,0% no CWE-bench, que mede a correção na raiz. Em desenvolvimento web, o modelo subiu 89 pontos e ficou em 4º lugar no WebDev Arena, com 1769 pontos. O Google também afirma que o Carbon gera código seguro com mais que o dobro da taxa do Argon e que o time do Chrome obteve resultado mais de dez vezes melhor na geração de correções de alta qualidade do que com um modelo de fronteira de outro laboratório. No benchmark de injeção indireta de prompt do Gray Swan, o Carbon resistiu a todas as tentativas avaliadas (0,0% de sucesso de ataque, contra 0,7% do Argon), em avaliações feitas sem as proteções de guardrail, como o Google registra.
Por que o acesso é limitado — e quem usa primeiro
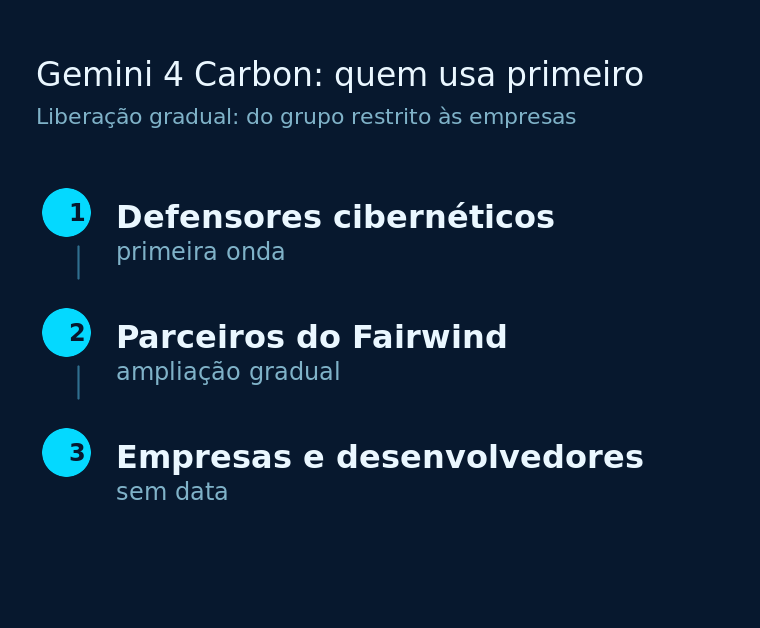
O Carbon não está à venda. O Google diz que está participando do processo voluntário de testes pré-lançamento do governo dos Estados Unidos e que, a partir desta semana, libera o modelo para um subconjunto de defensores cibernéticos. A ampliação para outros parceiros de confiança será gradual, pelo Fairwind Program, e o texto oficial só promete levar o Carbon a desenvolvedores, empresas e consumidores “o mais rápido possível” — sem data.
A Ars Technica descreve o mesmo roteiro do Argon e lembra que o lançamento escalonado pode demorar. O Argon, lançado antes, começou a chegar aos assinantes pagos e à API antes de qualquer liberação ampla. Para o Carbon, o Google não promete prazo nem confirma quais produtos recebem o modelo primeiro.
Para uma empresa que não é de cibersegurança e não está nos Estados Unidos, a leitura prática é simples: o Carbon é anúncio, não opção de contratação. O que existe hoje para testar é o Argon e os modelos de outros fornecedores.
Os números: onde o Carbon ganha e onde empata
O primeiro lugar no índice do Google não é o mesmo que liderança em tudo. A leitura independente do Artificial Analysis mostra o Carbon na frente em 4 das 9 avaliações do índice, mas em segundo lugar entre agentes de código, com 59 pontos contra 62 do Claude Opus 5.5 na configuração máxima. O Carbon também fica atrás do Opus 5.5 no Terminal-Bench 4.0 e no FrontierCode v1.1, onde marca 51% contra 56% do rival.
Em trabalho de conhecimento agêntico, o modelo melhorou 126 pontos de Elo sobre o Argon, para 1609, mas continua atrás de Grok 4.7, Muse Wonder e Kimi K3.1 Pro. A taxa de alucinação subiu de 4% para 11% na versão 1.1 do índice de omnisciência, ainda assim a segunda menor da lista, atrás apenas do Argon. É um retrato menos triunfal do que a manchete do anúncio: ganho real, margem curta.
A Ars Technica levanta uma hipótese que o Google não confirma: o Carbon pode ser um pós-treinamento do Argon, não um modelo totalmente novo. Os dois têm muito em comum e as diferenças aparecem em pontos percentuais, não em ordens de grandeza. A metodologia do Google registra que os números dos concorrentes são autodeclarados.
Quanto custa usar o Gemini 4 Carbon
O preço anunciado é introdutório e em dólar: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com desconto de 95% nos tokens de entrada armazenados em cache. O Google diz que é o mesmo valor de entrada do Argon e não informa quando o período promocional termina. A Ars Technica registra que o preço dobra depois da fase introdutória, para US$ 4 e US$ 20, e que as tarifas promocionais do Argon valem até o fim de novembro — para o Carbon, não há data.
O custo por tarefa medido pelo Artificial Analysis ajuda a comparar: US$ 7,76 por tarefa do índice, cerca de 23% menos que o Claude Opus 5.5 na configuração máxima, mas aproximadamente 1,2 vez o custo do GPT-6 Astra. O modelo usa 123 mil tokens de saída por tarefa, 29% menos que o Opus 5.5.
O que isso muda para a PME brasileira
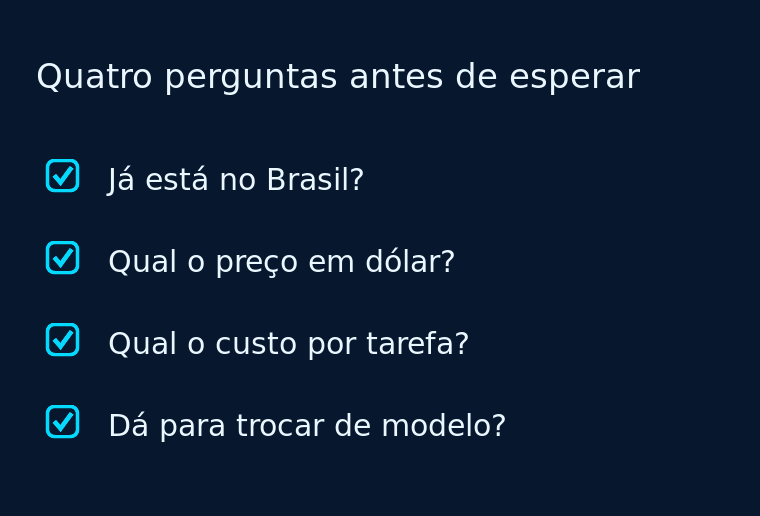
Na prática, nada muda no contrato desta semana. O Carbon não está disponível para empresas brasileiras, não tem preço em real e não tem data de chegada à API. O que muda é a decisão de arquitetura: se a empresa está montando agentes ou fluxos de automação, vale escrever o código para trocar de modelo sem reescrever o processo, porque o intervalo entre o Argon e o Carbon foi de duas semanas e a liderança de benchmark tem validade curta.
Para quem usa IA em atendimento, conteúdo ou análise, o caminho realista é testar o que já está disponível e medir custo por tarefa no próprio caso de uso, não no ranking. Para empresas que desenvolvem software, o avanço em cibersegurança é o ponto mais relevante: ferramentas que encontram e corrigem falhas com menos intervenção humana mudam o custo de manutenção — quando o acesso chegar.
Riscos e limites de planejar em cima do anúncio
Os números de destaque são do fornecedor, medidos em condições que ele escolheu; o índice independente confirma a liderança geral, mas mostra empates e derrotas em categorias específicas. Não há data para o modelo amplo, e o acesso inicial passa por um programa de cibersegurança dos Estados Unidos, o que pode deixar empresas brasileiras fora da primeira onda. Prometer ao cliente um recurso que só existe no anúncio é o tipo de erro que custa contrato, e o custo em dólar está sujeito a câmbio e a mudança de tarifa depois da promoção. Benchmark não é produção: um modelo que lidera tarefas longas em laboratório pode ser caro ou lento demais para o fluxo real de uma PME.
Fontes
- Google — Gemini 4 Carbon: our next frontier model, 28/10/2026 (anúncio oficial, aberto em 28/10/2026).
- Google DeepMind — metodologia de avaliação do Gemini 4 Carbon, 28/10/2026 (condições dos benchmarks e ressalva sobre números de terceiros).
- Artificial Analysis — Gemini 4 Carbon is the new #1 on the Intelligence Index v5, 28/10/2026 (índice independente).
- Ars Technica — Google announces Gemini 4 Carbon, its latest frontier AI model that you can’t use, 28/10/2026 (disponibilidade e preço).
O próximo passo
Se a sua empresa está escolhendo modelo para automação ou atendimento, a decisão útil não é esperar o próximo anúncio: é mapear o processo, definir o custo aceitável por tarefa e testar com o que está disponível hoje. A Canis ajuda a montar esse teste com IA e automação aplicadas ao negócio. Para entender como outro lançamento de modelo mexeu com preço, vale comparar com o caso do GPT-6.1 Terra: a lógica de preço introdutório se repete.


