

Tópicos desta notícia (8)
- 01O que o Google lançou em 11 de novembro
- 02Três tipos de pergunta e uma confiança que decide o fluxo
- 03A OpenAI já estava nesse mercado — e o preço é o mesmo
- 04O que os benchmarks dizem — e o que eles não dizem
- 05O que isso muda para a PME brasileira
- 06Riscos e limites antes de colocar em produção
- 07Fontes
- 08Fechamento
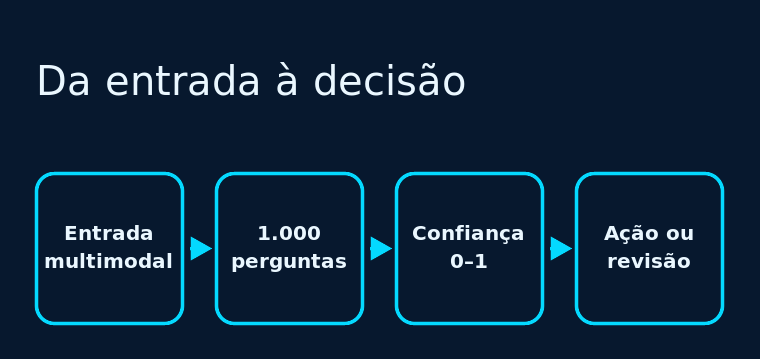
O Google lançou nesta quarta-feira (11) a Gemini Decisions API, endpoint da Gemini API que troca a geração de texto por respostas fechadas. Em vez de escrever um parágrafo token a token, o modelo gemini-decision-1 recebe uma entrada multimodal — texto, imagem, áudio, vídeo ou PDF — e devolve probabilidade, escolha ou nota para até 1.000 perguntas numa única passada, segundo o anúncio oficial. É a entrada do Google numa categoria que a OpenAI abriu em outubro: as duas APIs transformam um julgamento em número e cobram o mesmo preço por milhão de tokens de entrada.
O que o Google lançou em 11 de novembro
A API fica na Gemini API, dentro do Google AI Studio, em v1beta. Aceita uma entrada de até 256K tokens e até 1.000 perguntas independentes por requisição, com 50 a 100 ms de computação do modelo e 150 a 250 ms ponta a ponta; a latência fica quase plana de 1 para 100 perguntas em contextos de até 16K tokens.
O preço é US$ 0,10 por milhão de tokens de entrada, sem cobrança de saída. A entrada é cobrada uma vez por requisição; cada pergunta soma só os tokens da instrução e dos critérios. Não há cobrança de raciocínio variável nem de transcrição de áudio ou OCR, e o AI Studio tem um tier sem custo para prototipar.
O acesso inicial é só pela Gemini Developer API v1beta: sem Vertex AI, com o suporte no Google Cloud anunciado como “em breve”, sem cache de contexto, Batch, Flex ou Priority, e instruções de pergunta apenas em texto.
Três tipos de pergunta e uma confiança que decide o fluxo
O modelo responde em três formatos. O noul, de sim ou não, devolve a probabilidade de uma condição valer, com critérios opcionais de verdadeiro e falso. A escolha múltipla aceita de 2 a 255 opções e devolve a vencedora e as probabilidades normalizadas de todas. A nota em rubrica ordenada devolve uma pontuação contínua e a probabilidade de cada nível.
Toda resposta traz uma confiança de 0 a 1 — o que permite usar o endpoint como controle de fluxo: confiança alta segue automática, dúvida vai para fallback, modelo maior ou pessoa. As perguntas não se veem: incluir ou remover uma não muda as outras, então decisões dependentes ficam na lógica da aplicação.
A OpenAI já estava nesse mercado — e o preço é o mesmo
A Decisions API da OpenAI chegou à disponibilidade geral em 22 de outubro, sobre o GPT-6 Luna, com os mesmos três tipos de resposta e até 400 perguntas por requisição. O preço é idêntico: US$ 0,10 por milhão de entrada, sem cobrança de saída, com entrada em cache a US$ 0,01 por milhão. O Google multiplica por 2,5 o teto de perguntas, mas o anúncio não menciona desconto para cache nem residência de processamento; a OpenAI lista processamento nos Estados Unidos e na Europa e opção de retenção zero.
O que os benchmarks dizem — e o que eles não dizem
O Google afirma que o Gemini Decision 1 lidera o conjunto de benchmarks que escolheu, com o menor erro de calibração entre os modelos comparados, e que a combinação é quase cinco vezes mais barata do que o Gemini 3.5 Flash-Lite pela Interactions API.
A própria tabela do Google mostra onde ele não lidera: a Jev 1.14, da TypeSafe, ficou à frente em Mind2Web Multimodal, com 86,8% de acerto contra 86,2%, e em When2Call, com 82,0% contra 79,9%, e saiu mais barata por tarefa (US$ 0,68 contra US$ 0,88), segundo a leitura publicada pela Sulat.
O retrato independente é mais duro. No Decision Index v2.1 da Artificial Analysis, o modelo marcou 66 pontos e ficou atrás de Drex Max v1.1 e GLiDE v1.2, ambos com 73, e de Mammoth 27B e d1-ultra, com 71. No teste AA-Paperclip, só 33% dos documentos tiveram as 15 respostas corretas, contra 63% do Drex Max, e o custo por milhão de tarefas ficou em US$ 345 contra US$ 103. “Lidera os benchmarks” vale para o conjunto do fornecedor, não para toda tarefa de decisão.
O que isso muda para a PME brasileira
A conta que interessa é por interação. Uma operação com 100 mil mensagens por mês e cerca de 300 tokens de entrada por mensagem chega a 30 milhões de tokens — US$ 3 por mês, perto de R$ 17 pela cotação de 11 de novembro. Na proporção de “quase cinco vezes” divulgada pelo Google contra o Gemini 3.5 Flash-Lite pela Interactions API, seriam US$ 15, ou R$ 83.
São valores pequenos porque o custo do modelo deixa de ser o gargalo: pesa a infraestrutura de atendimento, a integração e o tempo de quem configura as perguntas. Por isso o endpoint interessa para triagem de atendimento, qualificação de lead, moderação e roteamento entre modelos — tarefas com resposta entre poucas opções e volume alto. No Brasil, o caso óbvio é o WhatsApp: classificar a intenção antes de acionar um humano ou um modelo maior.
Riscos e limites antes de colocar em produção
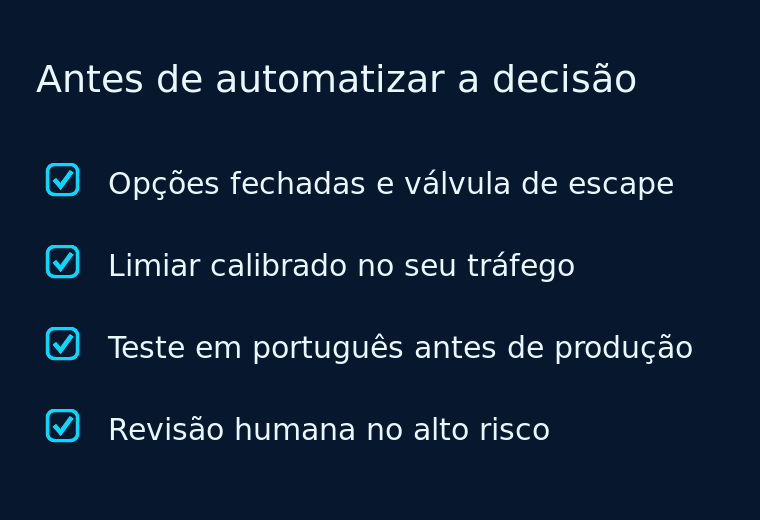
O primeiro limite é o conjunto fechado: o modelo não escreve, não planeja e não resume. Se a resposta correta não estiver entre as opções, ele escolhe a menos ruim — toda pergunta precisa de uma válvula de escape, como “incerto” ou “outro”, e de uma regra para ela.
O segundo é que confiança não é acerto. A calibragem do fornecedor não garante a calibragem no seu domínio, em português e com os seus dados; a documentação recomenda definir limiares com exemplos rotulados do seu tráfego e manter uma pessoa ou uma segunda checagem em ações de alto risco, como pagamentos.
O terceiro é o estado do produto: v1beta, sem Vertex AI, sem cache nem lote, com instruções só em texto — para quem precisa de disponibilidade contratual, ainda é piloto. E o anúncio não detalha residência nem retenção de dados, o que pesa na conta da LGPD ao mandar mensagem de cliente para a API.
Fontes
- Google — Gemini Decisions API — anúncio oficial, 11/11/2026
- Unite.AI — Google lança a Gemini Decisions API — limites de acesso e calibragem, 11/11/2026
- Sulat AI & Tech News — leitura do Decision Index v2.1 — índice independente, 12/11/2026 no fuso Ásia
- OpenAI — Decisions API — preço, teto e condições, 22/10/2026
Fechamento
Para uma PME, a Gemini Decisions API não substitui o modelo que escreve: ela cria uma camada barata de julgamento antes dele. A decisão prática é testar com um lote pequeno do seu próprio tráfego, medir acerto e calibragem em português e só então definir os limiares de automação.
Quer avaliar onde uma camada de decisão cabe na sua operação? A Canis trabalha com automação e inteligência artificial aplicada ao marketing e ajuda a medir custo, latência e erro antes de trocar um processo.


