
Tópicos desta notícia (8)
O que o Google publicou em 26 de outubro
O Google atualizou nesta segunda-feira o guia Prevent user-generated spam on your site and platform, documento de orientação para sites que hospedam conteúdo criado por terceiros. A página, que agora traz a marca de atualização de 26 de outubro de 2026, ganhou uma seção chamada “Only index content meant for Search” — algo como “indexe apenas o conteúdo feito para a Busca”.
A recomendação tem duas partes. A primeira pede que o serviço avalie se as páginas que os usuários criam foram feitas para aparecer em buscadores ou apenas para serem abertas por quem tem o link. A segunda define o padrão: quando a página existe para compartilhamento direto, colaboração ou utilidade, e não para descoberta pública, aplicar a regra de noindex — por meta tag robots ou pelo cabeçalho HTTP X-Robots-Tag — ou bloquear o rastreamento em robots.txt por padrão.
O changelog oficial, na entrada “October 26”, resume a mudança como orientação para bloquear a indexação de conteúdo compartilhado por link e para monitorar abusos no Search Console. A justificativa registrada é ajudar as plataformas a manter fora do índice as páginas criadas por usuários que não foram feitas para a Busca e a detectar spam mais cedo.
Também mudou o parágrafo de abertura do guia. Antes ele falava de formulários de comentário e serviços de hospedagem; agora inclui “ferramentas que permitem aos usuários publicar páginas compartilhadas, conteúdo gerado ou aplicativos web”. É a diferença entre um blog com comentários e um produto que gera uma página por usuário.
Quais páginas entram na recomendação
A definição do Google é funcional, não tecnológica: entra a página que só faz sentido para quem recebeu o link. No dia a dia de uma empresa pequena, isso costuma aparecer em quatro lugares.
O primeiro é a página de orçamento ou proposta, gerada com o nome do cliente e o valor do serviço. O segundo é o catálogo ou a lista de produtos montada por um usuário. O terceiro é o resultado de uma ferramenta: simulador, calculadora, diagnóstico, relatório gerado automaticamente. O quarto é a área do cliente e qualquer tela de compartilhamento de um aplicativo.
Nenhuma dessas páginas é lixo por natureza. O problema é o que acontece quando elas são indexadas em massa: o buscador passa a gastar rastreamento com URLs que ninguém procura, e o site acumula páginas finas que podem ser lidas como conteúdo gerado em escala. O próprio guia lembra que os spammers aproveitam justamente esse tipo de abertura para criar muitas páginas em um site de confiança.
noindex ou robots.txt: por que não são a mesma coisa
O ponto mais delicado da recomendação é que ela oferece dois caminhos como se fossem alternativas simples. Não são.
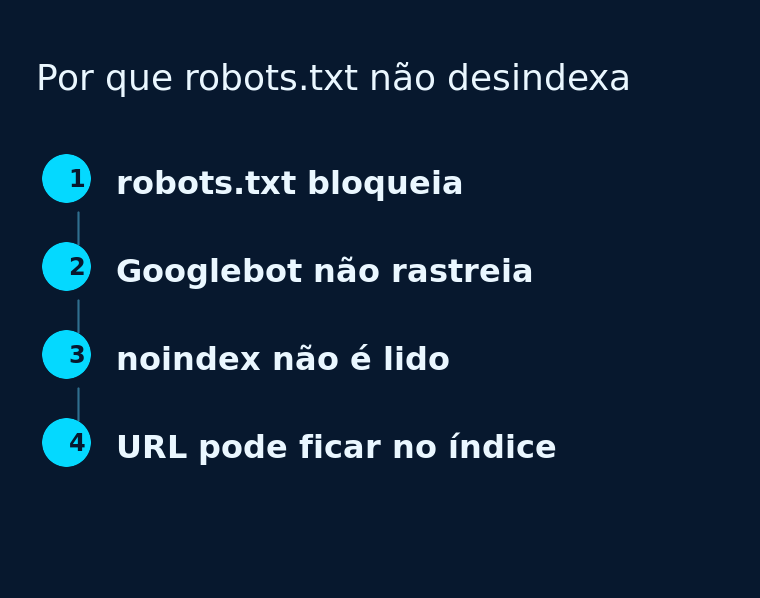
O noindex é uma instrução que o Google só obedece se conseguir ler a página. A documentação de bloqueio de indexação diz que a regra funciona quando a página não está bloqueada por robots.txt — se o rastreador não pode buscar o endereço, ele nunca vê a meta tag.
O robots.txt age antes: ele impede o rastreamento do endereço. Só que impedir o rastreamento não tira a URL do índice. A introdução ao robots.txt é explícita ao afirmar que a página bloqueada pode continuar indexada se outros sites apontarem para ela — e é exatamente o que acontece com um link de compartilhamento, que existe para ser colado em redes sociais, fóruns e mensagens.
Juntar os dois, portanto, pode dar o pior resultado: o robots.txt impede o Google de entrar e o noindex nunca é lido. A análise do PPC Land chama atenção para essa interação e lembra que a página “Control what you share”, revisada em 21 de outubro, lista o robots.txt como bloqueio apenas para imagens e vídeos.
Na prática: para tirar a página dos resultados, o caminho é noindex e página rastreável. O robots.txt serve para reduzir rastreamento, não para desindexar.
O que monitorar no Search Console
A segunda metade da atualização é operacional. O guia pede que a plataforma verifique o site ou subdomínio no Search Console para receber alertas de ação manual e de problemas de segurança, e que acompanhe com regularidade o relatório de indexação de páginas e o de desempenho na Busca em busca de picos inesperados de páginas indexadas, impressões ou consultas fora do propósito do negócio.
Há uma recomendação nova, específica para quem opera plataforma: acompanhar a criação e a indexação no nível do sistema e criar alertas para picos de páginas públicas recém-publicadas ou para um pequeno grupo de usuários gerando uma fatia grande dos endereços indexáveis. É o sintoma clássico de abuso automatizado.
O que isso muda para a PME brasileira
A maioria das pequenas empresas não opera uma plataforma, mas muitas usam uma. Ferramentas de orçamento, catálogos online, geradores de proposta e páginas de resultado de simuladores são comuns justamente porque dispensam desenvolvimento próprio — e costumam publicar cada resultado como uma URL aberta.
Se o fornecedor da ferramenta adotar o noindex como padrão, essas páginas deixam de aparecer na Busca sem que o dono do negócio faça nada. Isso pode ser bom: um orçamento com nome do cliente e valor não deveria estar no Google. Também pode ser ruim: uma página de produto ou de conteúdo que a empresa queria indexar pode nascer bloqueada.
O outro lado é a privacidade. Uma página de orçamento compartilhada por link, quando indexada, expõe nome, telefone e valor para qualquer busca. Não é um problema de SEO apenas; é uma exposição de dado de cliente que a empresa não planejou.
Riscos e limites antes de aplicar
O primeiro limite é de natureza: o texto está no guia de prevenção de spam, não na página de políticas de spam, que é onde ficam as regras com ação manual. O PPC Land observa que o Google não anunciou fiscalização, prazo nem consequência para quem mantiver as páginas indexáveis. Tratar a recomendação como lei pode levar a bloquear o que deveria ranquear.
O segundo é o efeito colateral de aplicar noindex em massa. Uma regra ampla demais derruba páginas que trazem tráfego legítimo — categorias, produtos, artigos — e o recuo não é imediato: a página só sai dos resultados depois de novo rastreamento.
O terceiro é a receita pronta do robots.txt. Bloquear o diretório inteiro parece resolver, mas impede o Google de ver o noindex e ainda deixa a URL aparecer sem descrição quando há links externos apontando para ela.
Fontes
- Google Search Central — Prevent user-generated spam on your site and platform, atualizado em 26/10/2026, acesso em 26/10/2026.
- Google Search Central — Documentação: atualizações, entrada de 26/10/2026, acesso em 26/10/2026.
- Google Search Central — Bloquear a indexação com noindex, acesso em 26/10/2026.
- Google Search Central — Introdução ao robots.txt, acesso em 26/10/2026.
- PPC Land — Google tells platforms to noindex link-shared pages by default, acesso em 26/10/2026.
- Search Engine Roundtable, acesso em 26/10/2026.
- Dev.to — Google Updates Spam Guide With Indexing Advice for Shareable Pages, acesso em 26/10/2026.
Como decidir o próximo passo
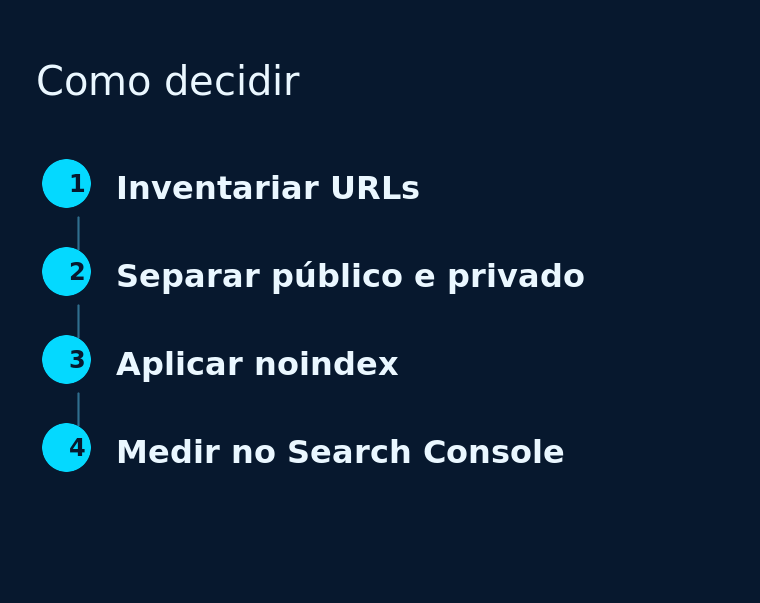
A decisão começa com um inventário, não com uma tag. Liste os tipos de URL que o site gera automaticamente, separe o que existe para ser encontrado do que existe para ser enviado a alguém e aplique noindex só no segundo grupo — sem bloquear o rastreamento daquelas páginas. Depois, acompanhe o relatório de indexação por duas ou três semanas para ver se o número de URLs indexadas caiu onde deveria.
Seu site publica páginas que não deveriam estar no Google? A Canis faz o inventário de URLs indexáveis, define o que deve ser público e aplica a regra certa em cada tipo de página. Veja como trabalhamos o SEO técnico.


