
Tópicos desta notícia (8)
- 01O que Illyes disse — e por que a distinção importa
- 02Rastrear, responder e treinar: o que o robots.txt não separa
- 03Google-Extended: o único controle de uso que o Google documenta
- 04O draft do IETF que criaria a regra de uso
- 05O que isso muda para a PME brasileira
- 06Riscos e limites: o que o arquivo e o draft não garantem
- 07Fontes
- 08O que fazer no seu site esta semana
O que Illyes disse — e por que a distinção importa
Gary Illyes, da equipe de Relações com a Busca do Google, afirmou que o robots.txt é, “como definido pela RFC 9309, um protocolo de preferência de acesso”. A declaração está em um episódio da série Non-Canonical Cabinet, publicado pelo Google Search Central em 21 de outubro de 2026, com Illyes e Cherry Prommawin.
A frase seguinte é a que interessa a quem administra site: o arquivo diz apenas se um crawler pode buscar esta ou aquela página e “não determina o que um sistema faz com os dados depois de já tê-los rastreado”. Permissão de rastreamento e uso no treinamento são decisões separadas — e o robots.txt alcança só a primeira. As citações deste texto são traduções do inglês.
A pergunta do episódio era essa: dá para liberar o rastreamento e impedir o treinamento no mesmo arquivo? A resposta é não — uma correção de expectativa, não um recurso novo.
Rastrear, responder e treinar: o que o robots.txt não separa
A especificação do Google reconhece quatro elementos: User-agent, Allow, Disallow e Sitemap. O resto é ignorado: o parser lê linha por linha e descarta o que não entende. No vídeo, os apresentadores usam uma diretiva fictícia para mostrar que o arquivo não é linguagem livre — o robô passa por ela e a joga fora, caractere por caractere.
Por isso “proibir treinamento” não funciona como texto: para barrar um crawler é preciso mirar o token de user-agent que ele declara. Regra inventada não cria comportamento novo.
A norma também limita o alcance. A RFC 9309 diz, na seção 1, que as regras “não são uma forma de autorização de acesso” — são um pedido que crawlers bem-comportados respeitam. A seção 2.2.4 permite interpretar registros fora do protocolo: quem inventa um campo de uso depende da boa vontade de quem lê.
São três decisões que o mercado trata como uma: deixar o bot ler a página; deixar o conteúdo aparecer em respostas geradas; e deixar o texto virar treino. O robots.txt responde à primeira.
Google-Extended: o único controle de uso que o Google documenta
O Google-Extended não é um crawler. Segundo a lista oficial de crawlers da empresa, o token não tem user-agent próprio: o rastreamento continua sendo feito pelos agentes que já existem, e o Google-Extended funciona “em capacidade de controle”. É a forma de dizer se o conteúdo já rastreado pode ser usado no treinamento de futuras gerações dos modelos Gemini que atendem o aplicativo Gemini e o Vertex AI, além do grounding — o uso de trechos do índice para embasar respostas na hora da pergunta.
A mesma página informa o que ele não faz: não afeta a inclusão do site na Busca e não é sinal de ranqueamento. Para quem quer “pode rastrear, não pode treinar”, esse é o instrumento disponível no Google — e vale para os produtos Google. Para os produtos de outros fornecedores, o controle depende do que cada empresa documenta.
Separe Googlebot de Google-Extended ao escrever a regra: bloquear o primeiro tira o site da Busca, do Discover e das imagens; o segundo mexe só no uso para treino e grounding. São linhas diferentes, com efeitos que não se substituem.
O draft do IETF que criaria a regra de uso
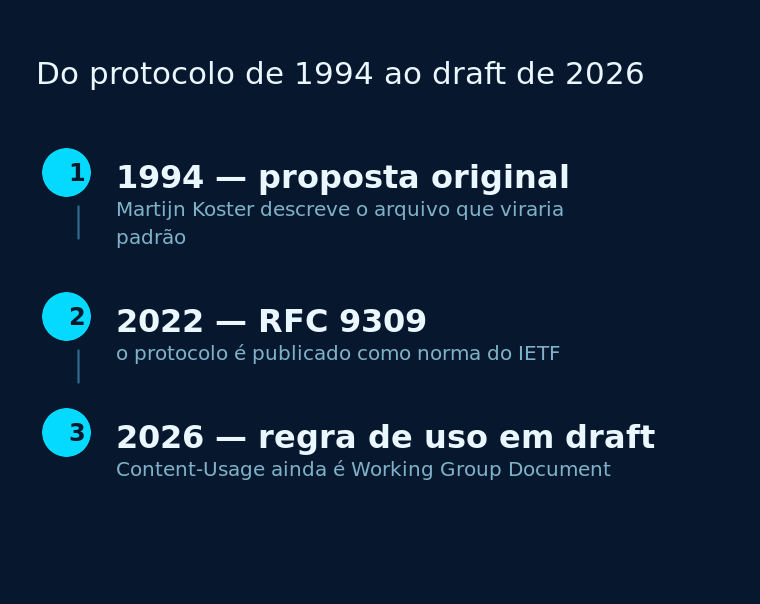
O draft-ietf-aipref-attach-05, de Illyes e Martin Thomson, da Mozilla, propõe padronizar o “não treine”: atualizar a RFC 9309 com uma regra Content-Usage no robots.txt e um cabeçalho HTTP equivalente. Allow e Disallow continuariam tratando de URLs; a nova regra diria como o conteúdo rastreado pode ser usado.
O status é o que importa: é um Working Group Document do IETF, atualizado em 19 de agosto de 2026, ainda não enviado ao IESG — o marco previsto era agosto de 2026 — e expira em 20 de fevereiro de 2027 se não for substituído. Não é padrão nem obrigação de ninguém. Quem vê “regra de IA no robots.txt” em proposta de consultoria deve checar se é o draft, o token de um fornecedor ou texto sem efeito.
O que isso muda para a PME brasileira
O Google responde por 88,41% da busca no Brasil em setembro de 2026, segundo o Statcounter. Para a maioria das empresas, a decisão não é “bloquear IA” no atacado: é escolher, bot por bot, o que se ganha e o que se perde. Bloquear rastreamento de busca para “proteger o conteúdo” costuma sair caro; bloquear só o uso em treino preserva a presença no índice.
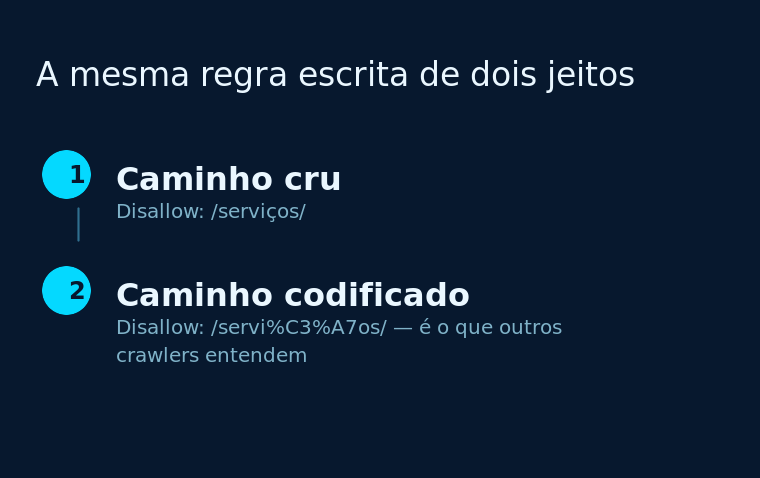
O segundo ponto é de quem opera site em português. No vídeo, a dupla recomenda escrever caminhos com caracteres não ingleses em percent-encoding. O parser do Google converte acentos sozinho, mas crawlers mais antigos podem se confundir — e o risco apontado é concreto: se o robô não entende o caminho, pode ignorar a linha Disallow inteira e rastrear o que você tentou proteger. Para um site com /serviços/ ou /notícias/, vale conferir como essas regras estão escritas.
O terceiro é de escopo: lista de “400 bots” copiada da internet resolve pouco se os tokens não correspondem ao que os fornecedores usam. A decisão madura é documentada — bot, função, motivo do bloqueio e quem revisa.
Riscos e limites: o que o arquivo e o draft não garantem
- Adesão voluntária. A RFC 9309 diz que as regras não são autorização de acesso. Crawler que ignora o arquivo não sofre consequência técnica — o bloqueio efetivo acontece no servidor ou no WAF, não no texto.
- Bloqueio de rastreio não é bloqueio de cópia. Quem já rastreou o conteúdo antes da regra continua com o material.
- Um token por fornecedor. O Google-Extended resolve o caso Google; os demais têm tokens próprios, com nomes e escopos que mudam sem aviso.
- O draft não é padrão. Pode mudar de sintaxe, perder apoio ou expirar em fevereiro de 2027.
- Nenhum dos documentos consultados traz medição de efeito. A decisão é por documentação, não por benchmark.
Fontes
- Google Search Central — What can you actually put in a robots.txt? (21/10/2026).
- Google — How Google interprets the robots.txt specification (atualizada em 31/08/2026).
- Google — List of Google’s common crawlers (atualizada em 14/07/2026).
- IETF — RFC 9309, Robots Exclusion Protocol (setembro de 2022).
- IETF — draft-ietf-aipref-attach-05 (19/08/2026).
- Statcounter — Search Engine Market Share Brazil (setembro de 2026).
O que fazer no seu site esta semana
Antes de mexer no arquivo, responda três perguntas: qual bot você quer barrar, o que ele faz hoje no site e o que acontece com sua presença na Busca se ele parar de rastrear. O ajuste costuma ser pequeno — separar o token de treino do de busca, revisar caminhos com acento e registrar a decisão para a próxima troca de fornecedor.
Se o seu robots.txt nunca passou por revisão técnica, o time de SEO da Canis faz a auditoria de rastreio e aponta o que está bloqueando o que não deveria.


