

Tópicos desta notícia (9)
O que muda em 30 de outubro
A partir de 30 de outubro de 2026, entram em vigor os novos Termos Comerciais da Meta — e a versão publicada em prévia traz uma cláusula de rastreio que alcança qualquer negócio que use os produtos dela, não apenas quem anuncia. O texto autoriza a Meta — e qualquer entidade que aja em seu nome — a usar software automatizado (“web scrapers, bots, robôs, spiders, rastreadores e agentes de usuário”) e a criar “credenciais de teste” para acessar, indexar, coletar ou rastrear domínios, páginas e URLs associados aos produtos ou serviços da empresa. O conteúdo reunido pode ser usado para “fornecer, desenvolver, melhorar, pesquisar, treinar” os produtos da Meta.
Quem discordar só pode interromper o uso comercial dos produtos — não há como recusar apenas a permissão de rastreio.
Quem é alcançado — inclusive quem não anuncia
Os termos valem para fins empresariais ou comerciais: veicular anúncios ou mensagens de marketing, vender ou listar produtos, administrar uma Página ou um Grupo, usar o Gerenciador de Anúncios ou o Business Suite, ou serviços de mensuração. Na prática, isso inclui o pequeno negócio que só mantém uma Página no Facebook, mesmo sem comprar anúncio algum.
A Meta diz que a atualização consolida cláusulas antes espalhadas — os termos de anúncios já previam rastreio de sites de anunciantes. A diferença está no alcance: sai o vínculo com a compra de anúncio, entra qualquer uso empresarial.
Os crawlers da Meta e o que o robots.txt controla
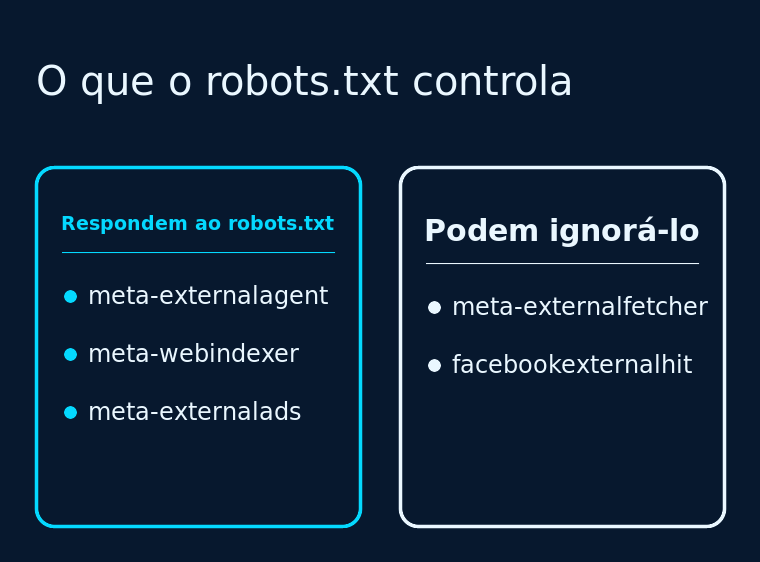
A Meta mantém cinco rastreadores, e a documentação oficial para webmasters explica cada um. O meta-externalagent coleta conteúdo para treinar modelos de fundação de IA e indexar páginas; o meta-externalads serve aos produtos de anúncio; o meta-webindexer alimenta as respostas do Meta AI — permiti-lo ajuda a citar e linkar o seu conteúdo.
Dois deles podem ignorar o arquivo: o meta-externalfetcher, que busca páginas a pedido de um usuário, e o facebookexternalhit, que monta as prévias de links e pode atravessar o robots.txt em verificações de segurança. Bloquear o facebookexternalhit tende a custar as prévias de link das suas páginas no Facebook e no Instagram.
Para bloquear, a receita da própria documentação é direta: um grupo User-agent: meta-externalagent seguido de Disallow: / mantém o treinamento de IA fora do site inteiro. Mudanças podem levar até 24 horas para valer: os rastreadores guardam o arquivo em cache.
O que a Meta diz — e o que os juristas apontam
A empresa nega mudança de comportamento: um porta-voz disse à imprensa que a atualização apenas consolida regras espalhadas e que não há mudança na forma como a Meta usa os rastreadores. Em 16 de outubro, o porta-voz Andy Stone repetiu a posição no X: a mudança serve para buscar informações precisas de produtos à venda em sites de terceiros — não para raspar sites de notícias.
A Nieman Lab ouviu três especialistas em direito digital. Matt Topic classificou a provisão como notável por estar enterrada nos termos de serviço, num mercado de licenciamento que valeria milhões. James Grimmelmann, de Cornell, disse que as credenciais de teste poderiam permitir que a Meta se cadastre como usuário falso para atravessar muros de registro — a empresa não respondeu se alcançariam paywalls.
Benjamin Sobel, de Wisconsin, vê venda casada: usar os produtos exigiria aceitar também as permissões de rastreio. A News/Media Alliance, associação de veículos dos EUA, chamou os termos de ultrajantes e provavelmente ilegais; na Europa, o Conselho Europeu de Editores levou preocupações à Comissão Europeia.
O que decidir até 30/10 — impacto para a PME brasileira
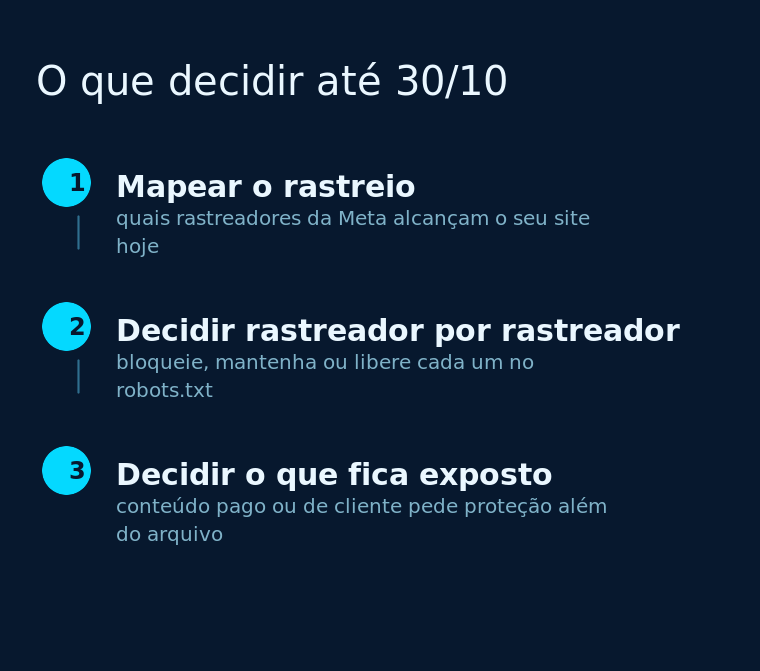
Para uma pequena ou média empresa brasileira que usa a Meta para vender, o prazo pede três decisões. A primeira é mapear: revisar o robots.txt e ver quais dos cinco rastreadores alcançam o site hoje. A segunda é escolher rastreador por rastreador: bloquear o meta-externalagent corta o uso do conteúdo no treinamento de IA, enquanto manter o meta-webindexer preserva a chance de o site ser citado nas respostas do Meta AI. A terceira é decidir o que fica exposto: páginas de produto já são públicas, mas conteúdo pago ou área de cliente pede proteção além do arquivo.
E o “não fazer nada” também é uma decisão: continuar usando a Meta para negócio depois de 30/10 significa aceitar os termos — não há recusa parcial. Quem opera para clientes deve avisar cada um: os termos exigem que quem age em nome de terceiros garanta o cumprimento das regras — e a cláusula vale para os sites dos clientes.
Riscos e limites
O robots.txt é uma instrução técnica, não um contrato: os termos não o mencionam, e os juristas dizem que a redação nova dá à Meta um argumento para alegar que os termos se sobrepõem a outras instruções de bloqueio. A empresa afirma que não pretende usá-los para ignorar o robots.txt de sites de notícias — mas a resposta foi dada à imprensa, não escrita nos termos. E mesmo quem bloquear os rastreadores que respondem ao arquivo continua exposto às duas exceções; o efeito real das “credenciais de teste” é desconhecido.
O que ainda não se sabe
- Se as credenciais de teste vencem muros de registro e paywalls — a Meta não respondeu às perguntas da imprensa.
- Se haverá revisão dos termos antes de 30 de outubro — entidades setoriais pedem adiamento.
- Como os rastreadores se comportam em sites brasileiros — sem dado público de volume; o tema aparece em relatos de webmasters.
- Qual será a leitura sob a LGPD — não há análise publicada; o debate citado é dos Estados Unidos.
Fontes
- Meta — Termos Comerciais (prévia; em vigor em 30/10/2026) — acesso em 16/10/2026
- Meta — documentação oficial de crawlers web — atualizada em 21/05/2026; acesso em 16/10/2026
- Meta — aviso no Business Help Center — acesso em 16/10/2026
- Nieman Lab — juristas analisam os novos termos — publicado em 15/10/2026; acesso em 16/10/2026
- Ars Technica — cobertura e posição da Meta — publicado em 15/10/2026; acesso em 16/10/2026
- The Verge — cobertura do mesmo fato — publicado em 15/10/2026; acesso em 16/10/2026
- News/Media Alliance — declaração setorial — publicado em 15/10/2026; acesso em 16/10/2026
Verificado nas fontes primárias da Meta e em quatro publicações independentes; trechos entre aspas são da versão oficial em português dos Termos Comerciais.
Conclusão
A cláusula de 30 de outubro é menos sobre bloquear tudo e mais sobre saber o que o seu site concede — e a quem. Revisar o robots.txt rastreador por rastreador e alinhar a decisão com quem cuida do site (ou dos sites dos seus clientes) evita uma permissão ampla por descuido.
Sua empresa sabe o que os rastreadores encontram no seu site? A Canis audita rastreio, organiza o robots.txt e conecta essas decisões técnicas ao que o site precisa entregar para vender — dentro do serviço de SEO. Falar com a Canis →


