

Tópicos desta notícia (8)
- 01O que o Google mediu — e por que não olhou nenhuma imagem
- 02As cinco categorias de uso que aparecem nos dados
- 03Quase 80% das conversas sociais incluem pessoas — e meme é o menor grupo
- 04Marketing: texto preciso, marca nova e pequeno negócio na frente
- 05O que isso muda para a PME brasileira
- 06Riscos e limites: o que o estudo não prova
- 07Fontes
- 08Como aplicar isso no próximo material
O Google publicou em 5 de novembro um paper que mede, com dados internos, o que as pessoas de fato pedem a um gerador de imagem. O objeto é o Nano Banana, o modelo de imagem do Gemini: a amostra reúne 2,1 milhões de conversas e 5,2 milhões de prompts, coletados em 90 dias do primeiro trimestre de 2026, e o texto completo está em arxiv.org/abs/2611.08749.
O achado que interessa a quem produz conteúdo é que o uso vai muito além da brincadeira. Os pesquisadores classificaram as conversas em cinco categorias, e a de marca e marketing é justamente a que concentra mais pedidos de pequenos negócios e de pessoas físicas — não de grandes anunciantes.
O que o Google mediu — e por que não olhou nenhuma imagem
O ponto de partida é um problema de privacidade. Quem usa geração de imagem costuma enviar fotos de si, da família e de clientes, e esse é um dos tipos de dado mais sensível que existe. Para estudar o uso sem vasculhar essas imagens, os pesquisadores aplicaram o Urania, framework do próprio Google que agrupa conversas com garantias formais de privacidade diferencial. No paper, o orçamento total de privacidade é de 0,04 — e, nessa medida, quanto menor o número, maior a proteção —, e o modelo que resume cada grupo nunca vê as conversas originais — só palavras-chave já tratadas, como explica o blog técnico do Google Research.
Na prática, isso significa que o estudo mede intenção declarada no texto, não o resultado visual. O que se conta é quantas conversas pedem tal coisa, e não se a imagem ficou boa.
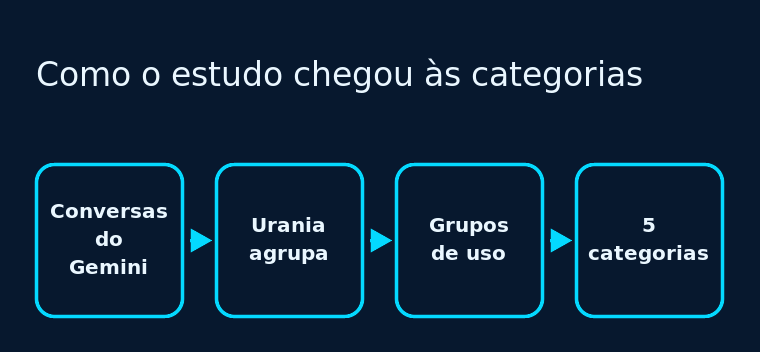
As cinco categorias de uso que aparecem nos dados
A taxonomia final tem cinco grupos: recriação e expressão pessoal (375 grupos de conversas, depois filtrados para as tendências virais), marca e marketing (191), produto e e-commerce (135), arquitetura e design espacial (66) e educação e informação técnica (64).
Um cuidado de leitura: esses números são grupos de conversas semelhantes, não a fatia de cada categoria no total. O paper não publica o percentual de conversas por categoria — a divisão serve para comparar como as pessoas escrevem em cada contexto, não para dizer “tanto por cento do uso é marketing”.
Quase 80% das conversas sociais incluem pessoas — e meme é o menor grupo
Nos grupos de conversas sociais e virais, o recurso mais presente é a inclusão de pessoas: aparece em quase 80% das conversas desse recorte, segundo o próprio paper. Também são comuns pedidos de composição (vários sujeitos na cena, posição precisa dos elementos, ajuste de iluminação) e de estilo (clima, técnica, referência visual).
Duas descobertas contrariam o senso comum. A primeira: meme e humor absurdo são os recursos menos presentes nesse recorte. A segunda: quando o resultado não agrada, o usuário tende a reescrever o pedido inteiro — a reescrita completa é cerca de duas vezes mais frequente que a iteração simples do tipo “tenta de novo”.
Marketing: texto preciso, marca nova e pequeno negócio na frente
Na categoria de marca e marketing, o que domina é controle de composição: posição dos elementos, presença de pessoas, iluminação e instruções sobre o que não deve aparecer. Personagens fictícios e narrativa aparecem pouco, e humor ou estrutura de meme praticamente não registram.
O dado mais útil para quem vende para pequenas empresas vem de outra pergunta do estudo. Boa parte do material de marketing é para marcas originais, fictícias ou que o modelo não reconhece — sinal de que muita gente está montando identidade visual de negócio novo, e não só ajustando peça de marca grande. E a categoria de marca e marketing teve a maior prevalência de conversas classificadas como pequeno negócio, profissional individual ou atividade paralela.
Também é ali que aparecem os pedidos mais exigentes de texto: é a categoria com mais instruções de tipografia e de especificação completa, à frente de educação e informação técnica, que cita texto em cerca de um terço dos casos.
O que isso muda para a PME brasileira
O Brasil aparece no estudo entre os países com concentração de uso do Nano Banana no primeiro trimestre de 2026, ao lado de Estados Unidos e Índia, e o português está entre os idiomas mais presentes na amostra. Ou seja: o comportamento descrito não é exótico, é o mesmo de quem opera negócio pequeno por aqui.
A leitura prática é que a ferramenta já é usada como produção, não como passatempo. Se o pedido define marca, texto e composição, o resultado tende a sair mais perto do que a empresa precisa; se o pedido é genérico, o retrabalho é maior. E o volume de pedidos com pessoas na cena é um lembrete operacional: foto de cliente ou de funcionário continua sendo dado pessoal e pede autorização de uso — o estudo não trata do tema, mas o problema aparece em qualquer rotina que suba imagem de gente para a IA.
Riscos e limites: o que o estudo não prova
O próprio paper lista as limitações, e elas importam para não transformar o achado em promessa. O estudo é descritivo: ele fotografa um trimestre e não mede se a IA criou atividades novas ou apenas barateou as que já existiam. Como analisa só o texto dos pedidos, pode subestimar usos ou perder categorias inteiras, e a classificação por LLM tem ruído — os autores chamam os números de direcionais, não precisos.
Há ainda duas lacunas práticas. O estudo não diz se o material gerado performou melhor em campanha, e não informa a fatia de conversas por categoria. Quem for usar os dados para decidir orçamento precisa tratá-los como retrato de comportamento, não como previsão de resultado.
Fontes
- Paper do Google no arXiv — metodologia, amostra, as cinco categorias e as limitações; aberto em 11/11/2026.
- Cobertura do LDS — resumo independente e ressalvas sobre a ausência de percentual por categoria; aberto em 11/11/2026.
- Blog técnico do Google Research sobre o Urania — como funciona a privacidade diferencial aplicada às conversas; aberto em 11/11/2026.
Como aplicar isso no próximo material
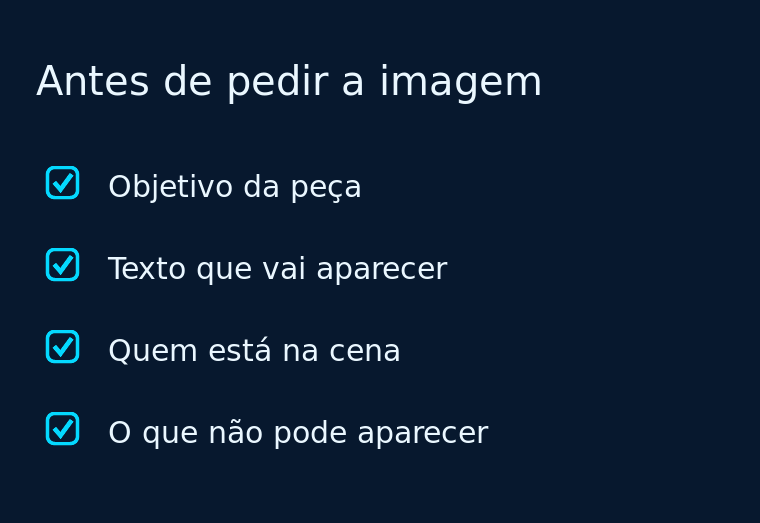
O estudo mede intenção, e intenção se escreve. Antes de gerar a imagem, um roteiro curto evita a reescrita completa que o próprio paper registra como o comportamento mais comum quando o resultado não agrada.
Se a sua equipe produz conteúdo com IA e quer padronizar esse processo, a Canis trabalha com automação e inteligência artificial aplicada ao marketing.


