

Tópicos desta notícia (7)
Em outubro de 2026, no Agentic Infrastructure Stack Summit da VentureBeat, o CIO da T-Mobile, Jeff Simon, contou o que aconteceu quando a operadora deu aos agentes de atendimento acesso a toda a documentação de suporte. A ideia era que o modelo viraria o especialista que sabe tudo. Não funcionou.
A T-Mobile opera agentes de atendimento desde 2024. O relato de Simon mostra que o problema não estava no tamanho do modelo, mas na escolha do que colocar dentro dele.
O que a T-Mobile tentou — e por que deu errado
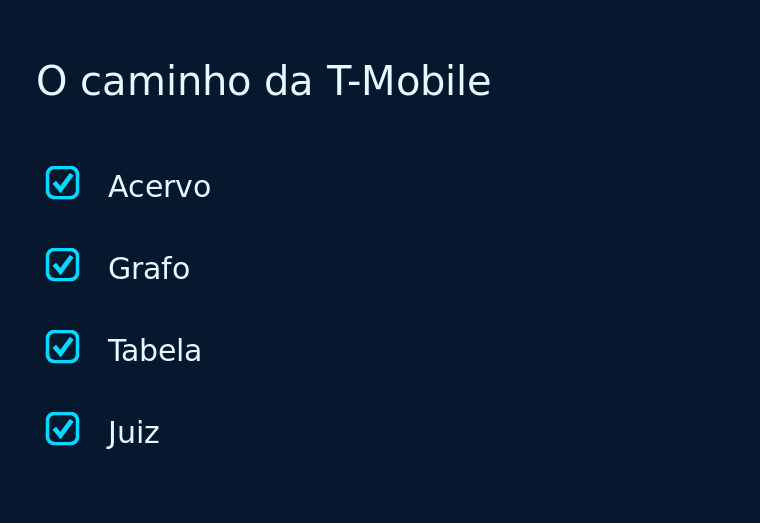
A primeira abordagem foi carregar o acervo inteiro. A documentação de uma empresa do tamanho da T-Mobile tem instruções conflitantes, e o pedido do cliente pode apontar para mais de um processo: quem pede “um aparelho novo” pode querer um telefone em uma linha existente ou uma linha adicional.
Com contexto demais, o modelo é forçado a decidir entre caminhos que a documentação não resolve, e pode escolher o errado com confiança. Simon resumiu: “That didn’t work at all.”
A segunda tentativa foi um grafo de conhecimento. O problema foi o tempo: os agentes precisavam procurar em um grafo grande, e o atendimento não tem folga. Como os clientes perguntam a mesma coisa de muitas formas, o agente podia se perder no caminho, mesmo com orientação. O grafo caiu.
A terceira abordagem é a que ficou: uma tabela de consulta em um banco de chave-valor, que mapeia as formas comuns de pedir algo para o caminho que o agente deve seguir. A equipe atualiza a tabela quando surge uma forma nova. Um agente orquestrador confirma o caminho e envia o pedido só para o agente com o contexto daquele caminho.
Simon diz que a tabela é básica, mas rápida e escalável. A T-Mobile também mantém um modelo menor ao lado do de produção em cada sessão, como juiz: ele sinaliza respostas erradas e clientes irritados para revisão humana. O custo é real, mas a operadora considera que vale.
O caso mais estranho que o juiz encontrou foi música de espera: o modelo a inventava quando pausava para buscar algo ou executar uma ferramenta. Os engenheiros passaram semanas investigando antes de achar a causa. Hoje o prompt diz para não alucinar música de espera.
A solução que funcionou foi uma tabela, não um modelo maior
Na prática, a T-Mobile separou duas decisões que costumam ser misturadas: qual é o caminho do cliente e qual é o contexto daquele caminho. O orquestrador resolve a primeira; o agente especializado recebe só a segunda. A tabela não é um modelo melhor, é roteamento.
Isso explica por que “jogar tudo no contexto” parece boa ideia e termina mal. Documentos acumulam versões, exceções e instruções contraditórias. Quanto mais material, maior a chance de o modelo achar dois caminhos válidos e escolher o errado. O volume não elimina a ambiguidade; esconde.
Por que mais contexto piora a resposta (e o que fazer no lugar)
O relato não é isolado. A pesquisa “Context Rot”, da Chroma, testou 18 modelos e mostrou que o desempenho cai à medida que a entrada cresce. A Anthropic descreve o contexto como recurso finito: o objetivo é o menor conjunto de tokens de alta qualidade para a tarefa, não o maior.
A pesquisa VB Pulse de outubro dá a dimensão: 78% dos 97 respondentes com agentes em produção rastrearam ao menos uma resposta confiante e errada ligada a contexto ausente ou inconsistente em seis meses. Entre os 76 que relataram falha, 42% disseram que o caso mais grave chegou a um cliente, a um relatório oficial ou a uma decisão revertida.
A amostra é autosselecionada e descreve os respondentes, não todas as empresas. Ainda assim, conversa com o relato da T-Mobile e com a Chroma: o problema não é ter informação, é ter informação demais, conflitante ou fora de hora.
Para quem monta um agente, a tradução é operacional: conferir se a base tem uma única versão de cada política, se os documentos antigos foram removidos e se o agente sabe o caminho antes de receber o conteúdo. Contexto curado vale mais do que contexto acumulado.
O que a PME brasileira deve copiar no atendimento
A escala da T-Mobile não se copia, mas o princípio sim. Uma PME que atende por WhatsApp, chat e telefone tem o mesmo problema em miniatura: preços desatualizados, políticas contraditórias e histórico que não passa do bot para o humano.
A pesquisa da Twilio divulgada em novembro mostra por que isso importa no Brasil: sete em cada dez brasileiros se sentem confortáveis com agentes de IA, mas 71% precisam repetir informações e 41% dizem que o humano não recebe o histórico. Outros 37% acham frustrante a IA que responde rápido sem reconhecer a conta ou o contexto. O levantamento ouviu mais de 1.400 consumidores da América Latina entre abril e maio de 2026.
Para uma PME, o caminho é começar pelos pedidos mais frequentes, ter uma fonte única para preços e políticas e garantir que o histórico chegue ao humano. A LGPD exige finalidade e necessidade no tratamento de dados; um agente que carrega tudo do cliente também aumenta o risco de expor o que não devia.
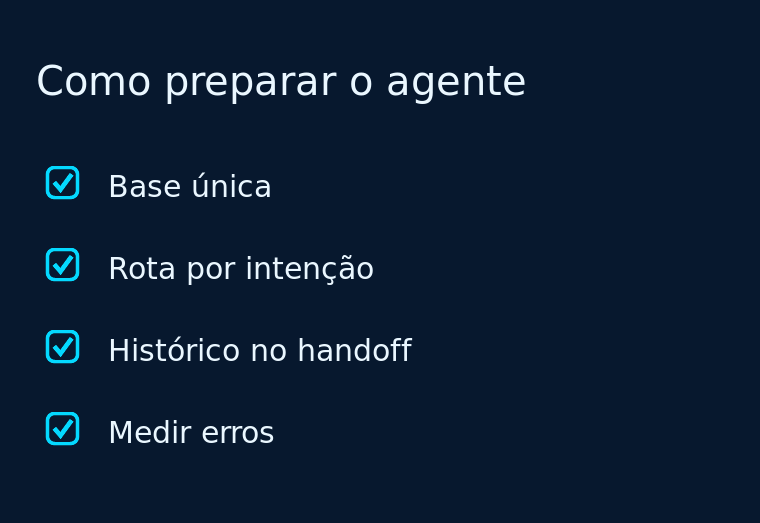
Medir também muda: além do tempo de resposta, vale olhar a taxa de respostas erradas, as sessões que precisaram de humano e os abandonos. É isso que mostra se o contexto ajuda ou só deixa o agente mais confiante.
Riscos e limites: um caso não é benchmark
O relato é um caso único, contado pelo CIO em um evento. A empresa não divulgou volume, taxa de acerto antes e depois nem o custo do segundo modelo. A avaliação de que a performance está boa é qualitativa, não um benchmark.
Também não vale concluir que todo contexto extra é ruim: em tarefas complexas, mais informação pode ajudar, desde que relevante e sem conflito. O problema da T-Mobile é de curadoria e roteamento, não de tamanho absoluto.
A tabela exige manutenção permanente: cada nova forma de perguntar pode pedir uma linha nova. E um roteamento errado pode frustrar o cliente antes de o agente especializado entrar. O juiz reduz o risco, mas não substitui revisão humana em casos sensíveis.
Fontes
- VentureBeat — Giving its AI more to read made T-Mobile’s answers worse — 20/11/2026, consultado em 20/11/2026.
- VB Pulse — Agentic Context Layers Report — outubro/2026, consultado em 20/11/2026.
- IT Forum — Brasileiros aceitam IA no atendimento — 04/11/2026, consultado em 20/11/2026.
- Chroma — Context Rot — julho/2025, consultado em 20/11/2026.
- Anthropic — Effective context engineering for AI agents — consultado em 20/11/2026.
Fechamento
O caso da T-Mobile desloca a pergunta: não é “quanto contexto o modelo aguenta?”, mas “qual contexto este cliente precisa para resolver o que pediu?”. Para a PME brasileira, a lição é começar pequeno, com uma base limpa e um caminho claro, e só ampliar quando a medição mostrar que vale.
Seu agente de atendimento responde bem ou só responde rápido? A Canis desenha agentes de IA com contexto curado, roteamento e métricas de qualidade. Falar com a Canis →


