
Tópicos desta notícia (7)
O que Cloudflare e OpenAI anunciaram em 15 de outubro
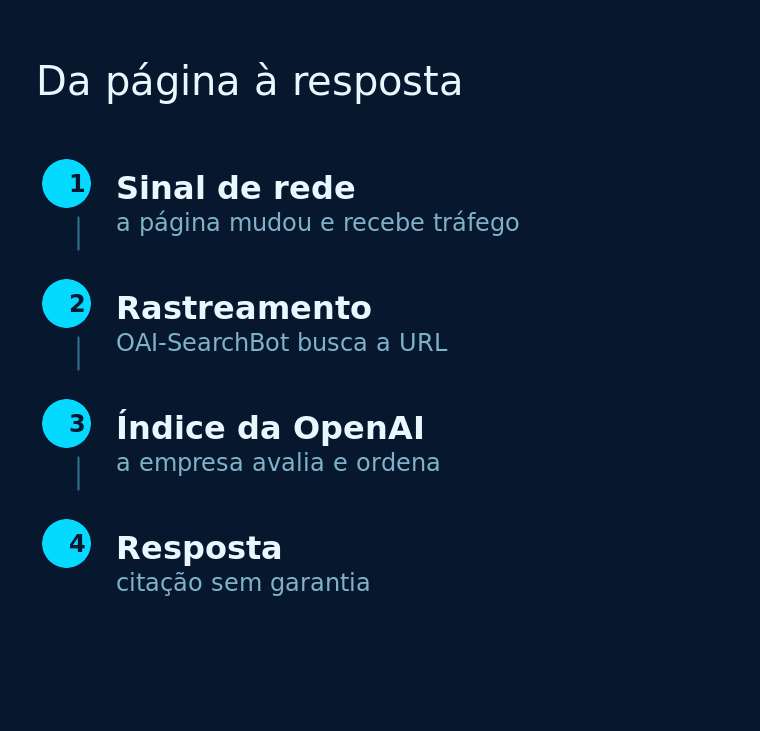
Em 15 de outubro de 2026, Cloudflare e OpenAI publicaram os primeiros resultados de um piloto de pesquisa anunciado em 8 de julho. A pergunta era se sinais da rede da Cloudflare ajudariam o rastreador da OpenAI a achar páginas que ele não encontrava. A resposta divulgada foi ampla — centenas de milhões de páginas novas entraram no índice que alimenta a busca do ChatGPT, segundo o post conjunto das duas empresas.
O teste rodou com uma coorte de cerca de 1% da rede total da Cloudflare. Mesmo nessa fatia, o volume de páginas inéditas passou do que o rastreamento por link alcançaria. A divisão de trabalho é explícita no anúncio: a Cloudflare fornece sinais sobre o que mudou, o que recebe tráfego e o que tem qualidade; a OpenAI avalia e ordena sozinha o que entra no índice e como aparece nas respostas.
O piloto nasceu de um programa maior, apresentado em 1º de julho, sobre o acordo entre quem publica e quem busca. A empresa afirma que mais de 20% da web está atrás da sua rede e pretende liberar a capacidade de forma ampla ainda em 2026, sem data definida.
Como o sinal de rede acha a página que o link não alcança
Um rastreador tradicional descobre a web seguindo links. O piloto ataca justamente esse ponto: a rede da Cloudflare vê o tráfego real que chega aos sites que protege e percebe quando uma página muda, mesmo que nenhum outro site a cite.
Os exemplos que o post usa são deliberadamente banais — o manual de um modelo específico de máquina de lavar, as exigências e taxas atuais de passaporte, o menu e o horário de um restaurante. O release de julho já listava os sinais envolvidos: frescor do conteúdo, qualidade do tráfego e mudanças efetivas de página.
Há também o efeito de limpeza. A Cloudflare relata que bots pedem arquivos que não existem, que alguns sites redirecionam quase qualquer endereço para a home e que outros endereços levam a cópias do mesmo conteúdo. Em 1º de julho, a empresa estimou que mais de 50% do tráfego dos bons rastreadores vai para páginas que não mudaram.
O post acrescenta um teste de segurança: sinalizar uma página comprometida, como um login falso, em vez de punir o domínio inteiro.
Indexar não é citar: o que o anúncio não mede
Estar no índice significa que a OpenAI pode usar a página como fonte. Não significa que ela será citada, nem que o leitor vai clicar.
O post não informa quantas das páginas novas foram citadas nas respostas do ChatGPT nem quantas visitas elas geraram. Também não diz quem participou da coorte de 1% nem se as páginas descobertas estão nos sites desses participantes. E admite um efeito colateral: encontrar páginas novas pode aumentar o rastreamento no começo.
A leitura correta tem três camadas. Descoberta é o que o piloto melhorou. Indexação é decisão da OpenAI. Citação depende da avaliação de relevância que a própria OpenAI faz — e o anúncio diz explicitamente que não há garantia de citação.
O que a PME brasileira controla — com ou sem Cloudflare
Não existe botão para entrar no piloto: nem o post de outubro nem o release de julho descrevem formulário, flag de painel ou plano comercial que coloque o site na coorte. Quem está atrás da Cloudflare recebe os sinais por padrão; quem não está continua dependendo dos caminhos antigos — links, sitemap e conteúdo que muda de verdade.
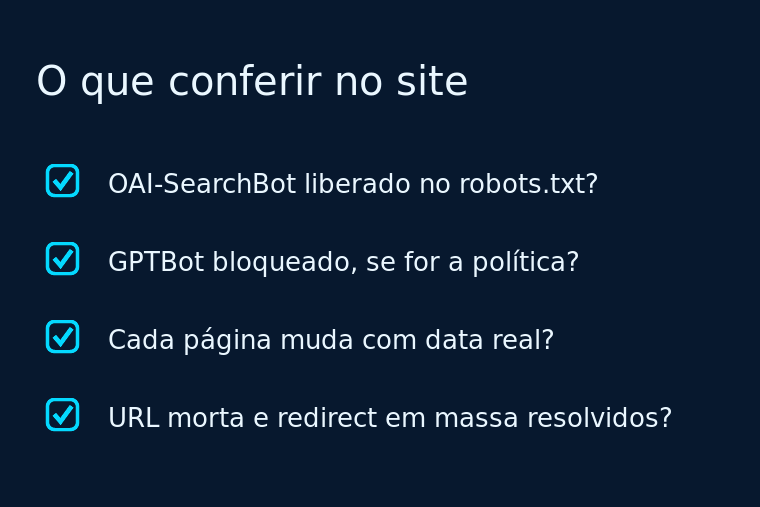
O que o dono de site controla é o acesso. A documentação da OpenAI separa três rastreadores que costumam ser tratados como um só. O OAI-SearchBot é o da busca: site que o bloqueia não aparece nas respostas de busca do ChatGPT, embora ainda possa aparecer como link de navegação. O GPTBot é o do treinamento: bloquear indica que o conteúdo não deve ser usado nos modelos. O ChatGPT-User busca a página quando alguém pede, e as regras do robots.txt podem não se aplicar a ele.
As duas decisões são independentes, e a própria OpenAI diz que pode aproveitar um único rastreamento para os dois usos quando o site libera ambos os bots. A mudança no arquivo leva cerca de 24 horas para valer. Para quem usa Cloudflare, o AI Crawl Control mostra quais serviços de IA acessam o site e permite liberar ou barrar rastreador por rastreador — o recurso está disponível em todos os planos, sem configuração.
O brasileiro já procura por isso: o autocomplete do Google no país sugere “como aparecer no chatgpt”, e a primeira página traz guias de otimização para IA. A pergunta existe; a resposta prática costuma parar na lista de boas intenções.
Onde o bloqueio tropeça
O erro mais comum é bloquear por causa do treinamento e perder a busca sem perceber. São chaves diferentes: barrar o GPTBot é opt-out de treinamento; barrar o OAI-SearchBot é sair das respostas de busca. Quem trata os dois como sinônimo resolve um problema e cria outro.
Há também uma tensão de posicionamento. A Cloudflare construiu parte da sua reputação em torno do bloqueio de rastreadores de IA e agora pilota descoberta com a OpenAI. A empresa antecipa a crítica no próprio texto: o programa é limitado à busca, não compartilha conteúdo e não usa nada para treinar modelos. E acrescenta que um sinal sobre uma página não concede permissão para acessá-la — a escolha do dono do site continua valendo.
O terceiro tropeço é de medição. Visita vinda do ChatGPT depende de referenciador ou de UTM, como o acervo já registrou. Sem esse dado, o dono de site não sabe se a página foi citada, se gerou clique ou se só entrou no índice — e tende a concluir que o trabalho falhou quando o problema é de instrumentação.
Fontes
Abertas em 20/10/2026. As citações de fontes em inglês foram traduzidas.
- Cloudflare — Cloudflare and OpenAI: making AI discovery better for everyone
- Cloudflare — Cloudflare Announces Research Pilot with OpenAI
- Cloudflare — Making AI search smarter
- Cloudflare — AI Crawl Control
- OpenAI — Overview of OpenAI Crawlers
- Reddit r/SEO — discussão sobre o piloto
Conclusão
O piloto não criou um atalho para aparecer no ChatGPT. Ele mostrou que a descoberta de páginas está deixando de depender só de link — e que a camada de rede, invisível para a maioria dos sites, passou a contar. Para a PME brasileira, a decisão da semana é menor: conferir se o robots.txt deixa o OAI-SearchBot entrar, manter o GPTBot fora do treinamento se essa for a política da empresa e garantir que as páginas mudem com data e conteúdo próprios.
Se você não sabe dizer o que o ChatGPT vê do seu site, esse é o diagnóstico que falta. Veja como trabalhamos SEO com foco em receita →. O acervo já tem o mapa de otimização para motores de busca, o recorte de SEO para pequenas empresas e o efeito de bloquear bots de IA por engano.


